السؤال
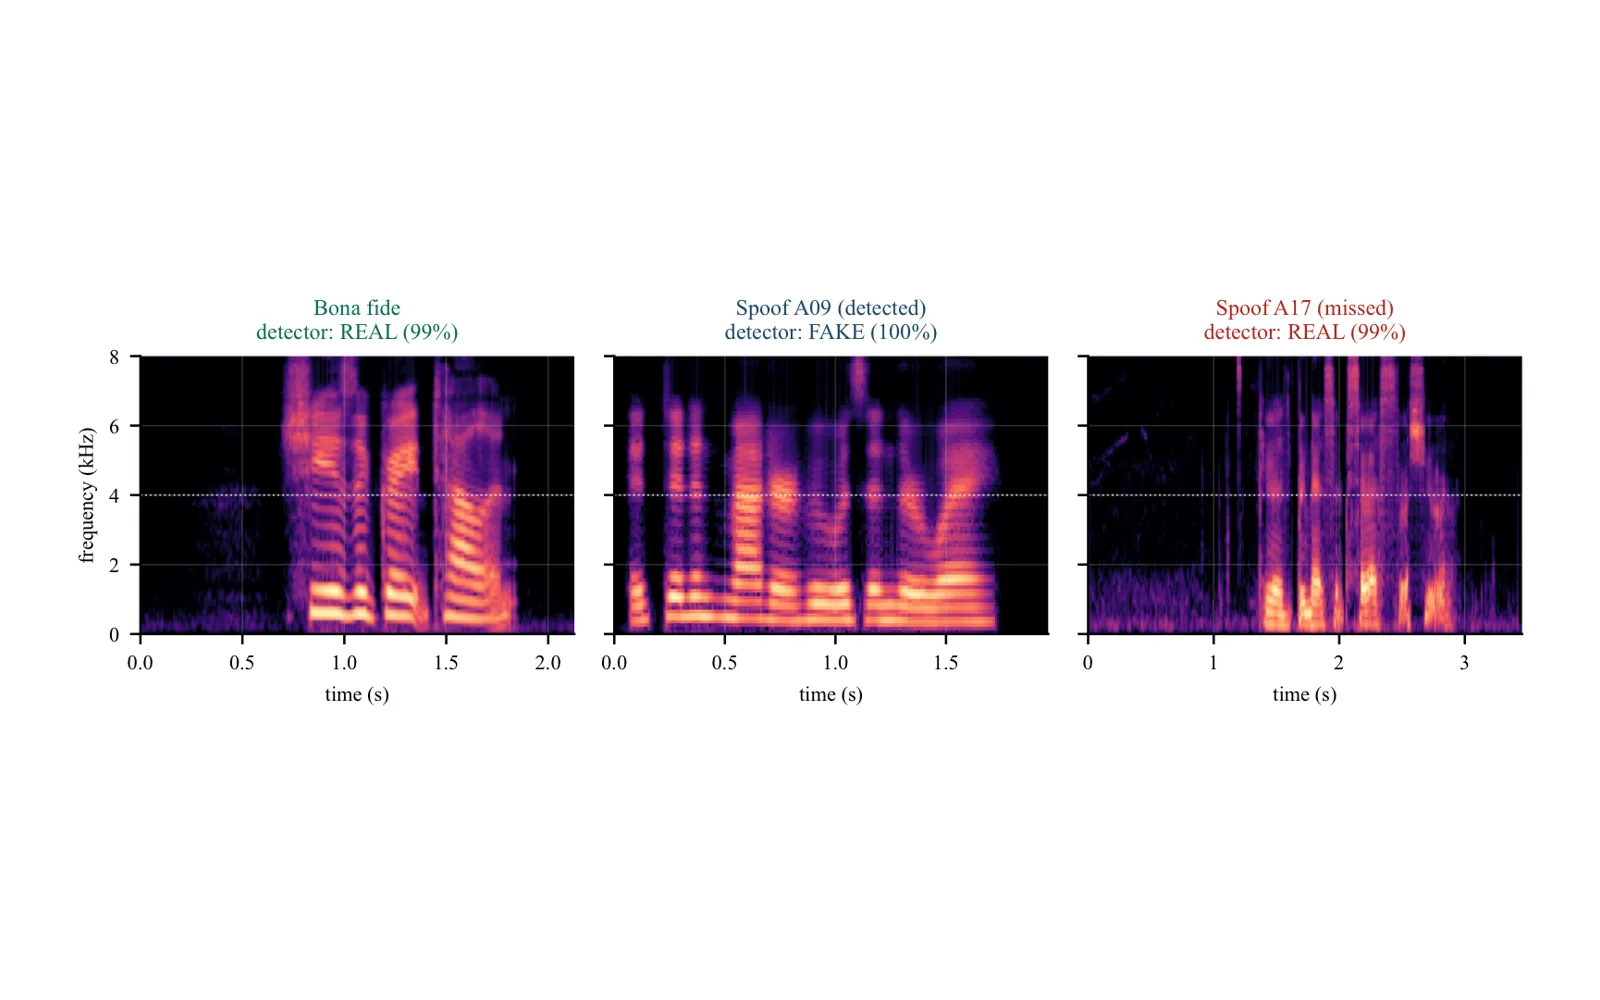
استنساخ الصوت صار رخيصاً. هل ما زالت خصائص الكلام التقليدية المصمّمة يدوياً (MFCC وLFCC وCQCC) مع مصنّفات بسيطة قادرة على التمييز بين الصوت الحقيقي والمصطنع، أم أن الكشف يحتاج إلى التعلّم العميق؟
كيف اختبرنا
مع Mohammadkhair Awwad في جامعة بيرزيت، درّبنا كاشفات على بيانات ASVspoof 2019 وقارنّا 69 نظاماً: مجموعات خصائص يدوية مع مصنّفات تقليدية مثل SVM، ونموذج LCNN على مخطط log-mel. واختُبر كل نظام على هجمات لم يرها، وعلى صوت مرّ بترميزات لم يسمعها، وعلى مدوّنة مختلفة كلياً.
ماذا وجدنا
- وصل نموذج LCNN إلى معدل خطأ متساوٍ 5.95% على ثلاث عشرة هجمة جديدة.
- في الاختبار عبر المدوّنات، كانت خمس إحصاءات بسيطة للصمت والمدة الأفضل بين الأنظمة الـ 69 كلها. تعلّمت الكاشفات اختصارات في بيانات التدريب بدلاً مما يجعل الصوت مصطنعاً.
- عنق الزجاجة الحقيقي هو التعميم، لا اختيار الخصائص.
معدل الخطأ المتساوي (EER) هو النقطة التي يرفض فيها الكاشف أصواتاً حقيقية بقدر ما يقبل أصواتاً مزيّفة؛ والأقل أفضل.